Сбер представил Kandinsky Avatar 1.0 — нейросеть для создания аватаров
Она способна оживлять не только людей, но и персонажей: животных или мультипликационных героев.
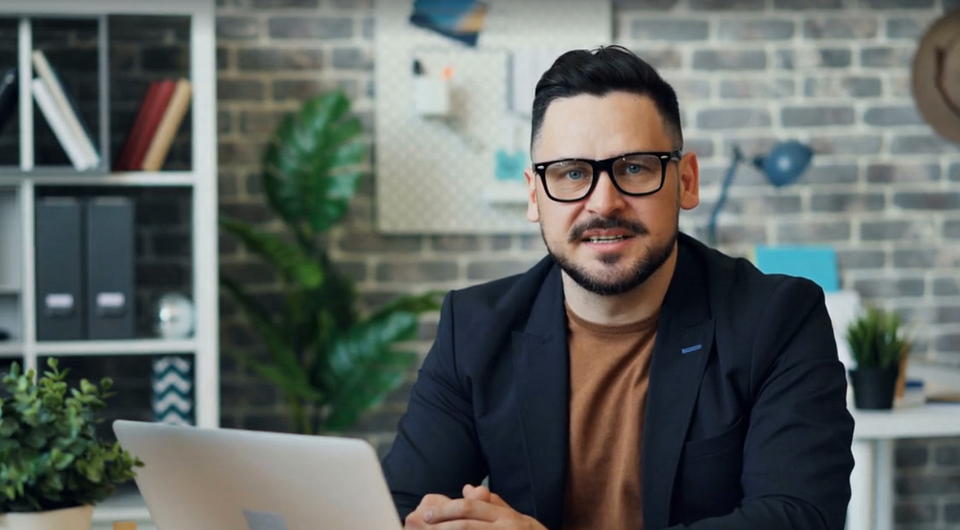
Сбер выложил в открытый доступ Kandinsky Avatar 1.0 — семейство российских моделей, которое создаёт говорящих видео-аватаров по изображению и записи голоса. Разработчики могут использовать модели в собственных сервисах, в том числе коммерческих. Kandinsky Avatar 1.0 делает ролики длиной до минуты с частотой 24 кадра в секунду. Kandinsky Avatar 1.0 стала первой полностью российской моделью, способной создавать реалистичных цифровых собеседников.
Код и веса моделей доступны для разработчиков бесплатно под открытой лицензией MIT на GitHub, GitVerse и Hugging Face. Моделью также можно будет воспользоваться в популярных инструментах для запуска и интеграции нейросетей — ComfyUI и Diffusers.
Как работает модель
Чтобы создать видеоаватар, модели достаточно изображения, аудиозаписи и короткого текстового описания сцены. Kandinsky Avatar синхронизирует движения губ с речью, и сама добавляет мимику, повороты головы и жесты. Эмоцию персонажа можно задать текстом, тогда аватар будет выражать радость, грусть или злость. Модель создаёт видео на любом языке: аватар говорит на языке аудиозаписи, которую ей передали. Kandinsky Avatar не синтезирует и не клонирует голос: модель работает только с изображением и аудиозаписью, которые предоставляет пользователь. Технология открывает возможности для обучения, бизнеса, творчества и самовыражения.
Кстати, у нас есть статья, в которой мы учим делать аватары, способные озвучивать тексты — достаточно просто написать, что им нужно зачитать.


 Читайте нас в социальных сетях